Qué puede leer un modelo de IA en un formulario de papel
Lo que hoy está medido sobre reconocimiento de manuscrito, por qué un error bajo por carácter no es un error bajo por campo, y qué no está en la tinta.
1,75 %
de error por carácter en manuscrito moderno (Crosilla, Klic y Colavizza, 2025). Por campo no es 1,75 %.
La pregunta llega en casi todas las conversaciones, y llega ya decidida: si hoy un modelo de inteligencia artificial lee cualquier cosa, ¿por qué no le pasamos las hojas escaneadas y nos ahorramos el terreno digital? Es una buena pregunta y merece una respuesta con números, no con entusiasmo. Fuimos a buscar los números.
Lo que está medido
El trabajo más útil que encontramos es de Crosilla, Klic y Colavizza, publicado en 2025 en Journal of Documentation con el título Benchmarking large language models for handwritten text recognition. Compara modelos multimodales de lenguaje contra Transkribus, que es el motor especializado del oficio, sobre corpus manuscritos en inglés, francés, alemán e italiano. La versión abierta está en arXiv:2503.15195.
Sobre escritura moderna en inglés —el corpus IAM— los modelos generalistas ganan con holgura: 1,71 % de error por carácter para GPT-4o-mini y 1,75 % para Claude 3.5 Sonnet, contra 9,13 % del modelo especializado de Transkribus. Sobre manuscrito histórico en italiano la cosa se da vuelta de signo pero no de orden: el mejor modelo queda en 20,55 % de error por carácter.
Dos advertencias antes de sacar conclusión. La primera es que el estudio mide el idioma: el desempeño cae fuera del inglés, y ninguno de sus corpus es castellano. La segunda es que ninguno de esos corpus es un formulario de inspección, con casillas, siglas de faena, abreviaturas de oficio y un «N/A» escrito de seis maneras distintas.
Por qué un 1,75 % no es un 1,75 %
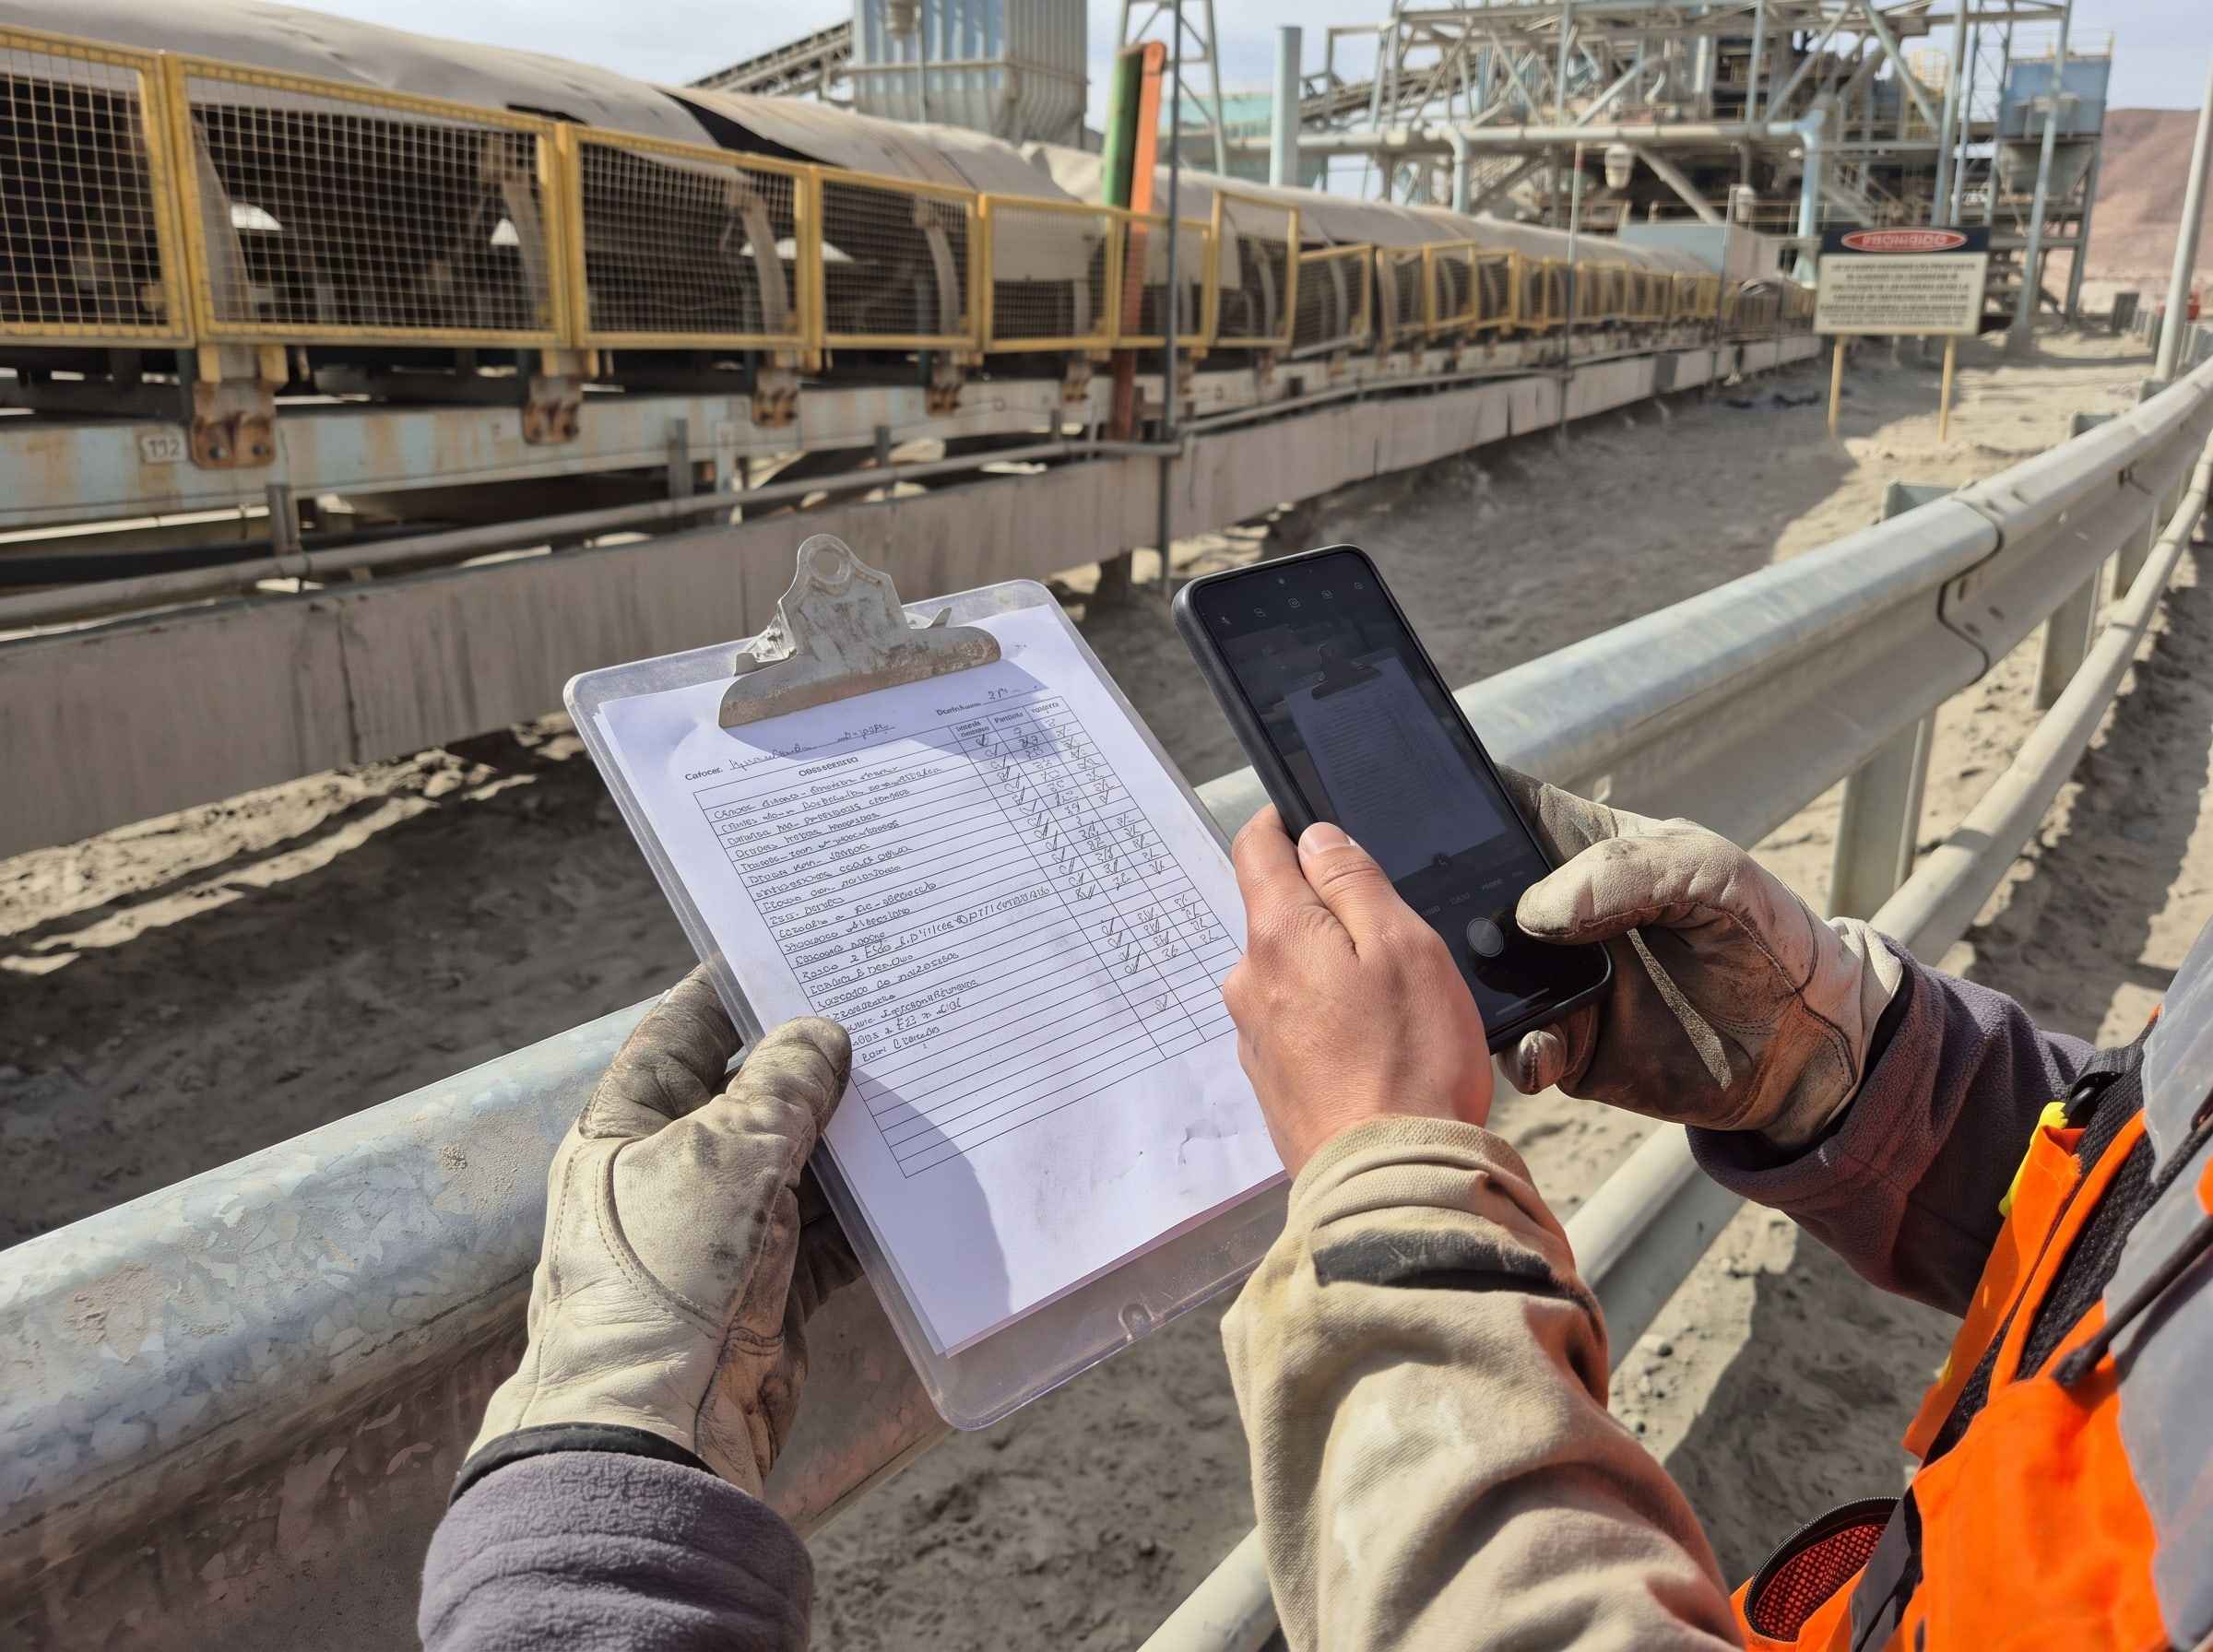
El error por carácter es una métrica de carácter, y un formulario se lee por campo. Si los errores cayeran uno a uno y al azar —no caen así, se agrupan—, un campo de seis caracteres leído con 1,75 % de error por carácter saldría mal algo más de una vez de cada diez. La cuenta es nuestra, es el peor caso y sirve para una sola cosa: para ver que una tasa baja por carácter no es una tasa baja por campo, que es la unidad que después entra en un informe, en una estadística o en un juicio.
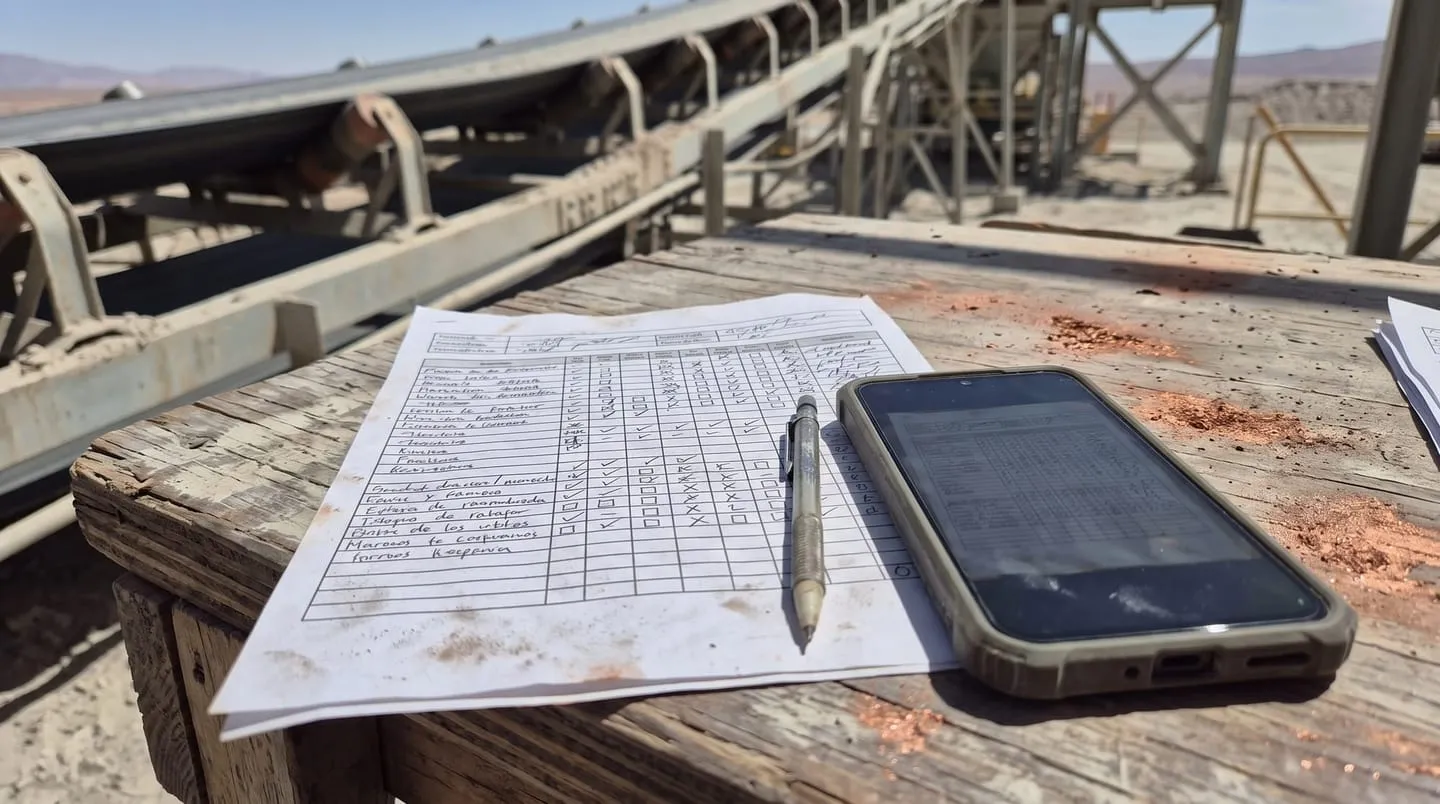
Imagen generada con IA a partir de referencias propias.
Lo que el modelo no puede hacer sobre sí mismo
El mismo estudio prueba algo que suele proponerse como solución: pedirle al modelo que revise su propia transcripción. La conclusión de los autores es que la autocorrección no produce una mejora sustancial sobre la predicción inicial; las mejoras son inconsistentes, y en los modelos abiertos la segunda pasada llegó a aumentar la tasa de error.
Eso tiene una consecuencia práctica. «Que el modelo se revise a sí mismo» no es un control de calidad: es la misma lectura otra vez. El control tiene que venir de fuera —de un humano, de una regla, de un segundo dato que no salga de la misma tinta—.
Lo que no está en la tinta
Hay un límite que no depende del modelo y que ninguna versión futura va a levantar, porque no es un problema de lectura.
Una hoja escaneada dice qué se escribió. No dice quién lo escribió, ni cuándo, ni dónde estaba esa persona, ni contra qué versión del formulario respondió, ni si la fotografía que se adjuntó tres días después corresponde a ese hallazgo o al de al lado. Ninguno de esos datos está en el papel, así que ningún modelo los puede recuperar: los inferiría, que es otra cosa, y en un registro que puede terminar en una fiscalización esa diferencia es la que importa.
Por eso la respuesta corta a la pregunta del principio es que la transcripción no crea procedencia. Capturar el dato estructurado en el momento y en el lugar en que ocurre es más barato que reconstruirlo después, y sobre todo es lo único que deja rastro de quién y cuándo.
Dónde sí sirve
Nada de lo anterior dice que el modelo no sirva. Dice dónde ponerlo. Sobre un dato ya capturado y ya trazado, un modelo hace bien cosas que una persona hace lento: redactar el borrador de una descripción, agrupar hallazgos parecidos de meses distintos, proponer una clasificación que después alguien confirma, encontrar la inspección de hace dos años que se parece a la de hoy. En todas ellas hay una persona que decide, y hay un registro anterior contra el cual verificar.
Lo que no medimos
No hemos hecho nuestro propio banco de pruebas sobre formularios de faena en castellano, y las cifras de arriba no son de ese material: son de corpus académicos, en otros idiomas y con otra letra. Sirven para acotar un orden de magnitud y para descartar la idea de que el problema ya está resuelto. No sirven para prometer un porcentaje sobre una hoja chilena escrita con guantes.
Fuentes
Crosilla G., Klic L. y Colavizza G., Benchmarking large language models for handwritten text recognition, Journal of Documentation, vol. 81 n.º 7 (2025), pp. 334-354: doi 10.1108/JD-03-2025-0082 · versión abierta en arXiv:2503.15195.